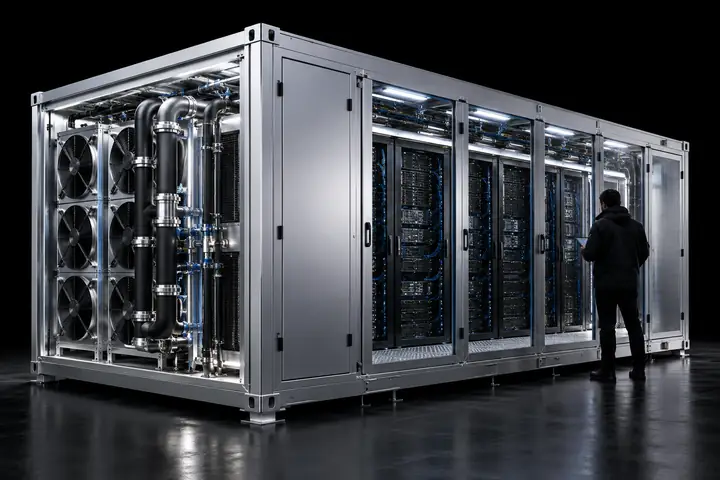
Reservierte Kapazität
Ab $0.99
pro GPU-hour im Serverless-Betrieb
- •Buchen Sie eine bestimmte Anzahl von GPUs für einen festgelegten Zeitraum.
- •Nutzen Sie bei Bedarf Kapazität über die Reservierung hinaus.
Entwickeln mit Runware
Vier Ebenen, die zusammenarbeiten. Orchestrierung und modulare Sonic Pods bilden die Sonic Inference Engine®.
Plattform erkunden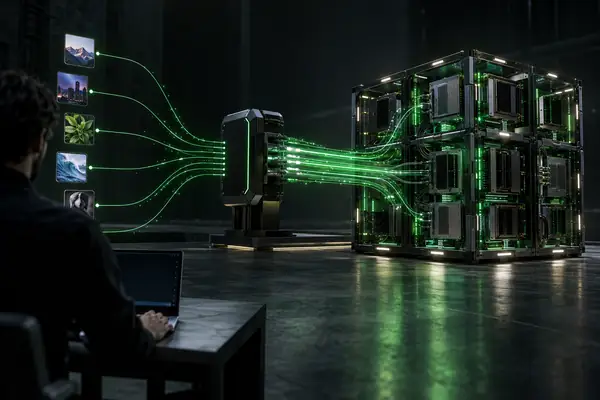
Inferenzanfragen für Bild, Video, Audio, Sprache und 3D bearbeitet.
Modelle, die über einen einheitlichen Ansatz für KI-Workloads zugänglich sind.
Entwickler, die mit Runware KI-gestützte Erlebnisse schaffen.
Menschen, die von Anwendungen auf der Infrastruktur erreicht werden.
Geringere Generierungskosten als die veröffentlichten Marktpreise für ausgewählte Modelle.
Gemeldete Plattformverfügbarkeit in den letzten 90 Tagen.
Modelle und Modalitäten an einem Ort – mit einem einheitlichen Weg vom Experimentieren bis zur Integration.
curl -X POST https://api.runware.ai/v1 \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -d '[
    {
      "taskType": "imageInference",
      "model": "runware:400@1",
      "positivePrompt":
        "machinery, green-to-yellow gradient",
      "width": 1024,
      "height": 1024
    }
  ]'
● Serverless · Früher Zugang
Bringen Sie Container und Modellgewichte auf die modulare GPU-Infrastruktur hinter der Runware-API. Skalieren Sie Ihre Workloads nach Bedarf, statt auch für ruhige Phasen Kapazität vorzuhalten.
Bringen Sie Ihren Container und Ihre Modellgewichte mit. Stellen Sie beides bereit, ohne die zugrunde liegende Infrastruktur verwalten zu müssen.
$1.99/hour für RTX PRO 6000, verglichen mit typischen veröffentlichten Preisen von $3.00–$4.00 anderswo. Die modulare Infrastruktur ist darauf ausgelegt, Rechenkosten zu senken.
Serverless-Starten Sie mit flexibler Rechenleistung. Sobald Ihr Grundbedarf feststeht, können Sie für Workloads mit gleichmäßigerer Nachfrage reservierte Kapazität oder dedizierte Hardware in Betracht ziehen.
Reservierte Kapazität
pro GPU-hour im Serverless-Betrieb
Bare Metal
individuelle Konfigurationen auf Sonic Pods
Speziell entwickelte Hardware, eine dedizierte Inferenz-Engine und vertraute Modelle können die Wirtschaftlichkeit der Generierung verändern.
Die angegebenen Zahlen dienen zur Veranschaulichung für dieses ausgewählte Modell und Volumen; die tatsächlichen Konditionen hängen vom Anbieter und Workload ab.
Beispielhafte monatliche Differenz
$29.1Kim obigen BeispielVergleiche ausgewählter Modelle
Verbinde deine Tools und integriere den Modellzugriff in deinen bestehenden Workflow. Starte mit einem API-Schlüssel und einer vertrauten Entwicklungsumgebung.
✓ verbunden · OAuth 2.1
✓ Tools · run · list_models · model_schema
>
Verbinde einen MCP-Client und arbeite über eine vertraute Oberfläche.
Rufe Modelle über dein Terminal auf.
Gib Coding-Agenten Anleitungen zur Nutzung von Runware.
„Großartige Preise und eine flexible API. Unsere Nutzer möchten jedes Modell, jeden Hyperparameter, jedes LoRA und jede Option ausprobieren. Andere Anbieter verteilen sie auf verschiedene Endpunkte. Runware vereint sie alle.“
Inferenz nahe an den Nutzern, ohne für jede neue Idee GPUs bereitstellen zu müssen.
Fragen, die Entwickler vor dem ersten API-Aufruf stellen. Erkunden Sie die Plattform, um mehr über Ihren eigenen Workload zu erfahren.
Nutzen Sie eine einheitliche API-Struktur für unterstützte Bild-, Video-, Audio-, Sprach- und 3D-Aufgaben, statt jede Modalität von Grund auf neu anzubinden.
Sie vereint Orchestrierungssoftware und modulare Infrastruktur, die speziell für Inferenz entwickelt wurden.
Das Ziel ist, dieselben Modelle auf effizienterer Infrastruktur auszuführen und so den Rechenaufwand zu senken, statt das von Ihnen gewählte Modell zu ändern.
Dedizierte Rechenkapazität ist eine Option, wenn ein Workload eigene Kapazitäten und eine eigene Hardwarekonfiguration benötigt.
Runware gibt an, dass Kundeneingaben und -ausgaben nicht zum Trainieren von Modellen verwendet werden. Prüfen Sie die für Ihren Anwendungsfall geltenden Bedingungen zur Datenverarbeitung.