Capacidad reservada
Desde $0.99
por GPU-hour en cómputo sin servidor
- •Comprométete a usar una cantidad de GPU durante un plazo determinado.
- •Supera la capacidad reservada cuando lo necesites.
Desarrolla con Runware
Cuatro capas diseñadas para trabajar juntas. La orquestación y los Sonic Pods modulares forman el Sonic Inference Engine®.
Explora la plataforma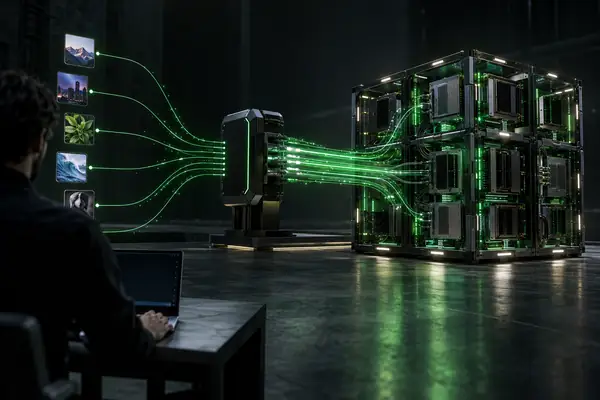
Solicitudes de inferencia atendidas en imagen, vídeo, audio, lenguaje y 3D.
Modelos accesibles mediante un enfoque unificado para las cargas de trabajo de IA.
Desarrolladores que crean experiencias impulsadas por IA con Runware.
Personas alcanzadas por aplicaciones que funcionan sobre la infraestructura.
Costos de generación más bajos que las tarifas de mercado publicadas para determinados modelos.
Tiempo de actividad registrado de la plataforma durante el período más reciente de 90 días.
Modelos y modalidades en un solo lugar, con un recorrido uniforme desde la experimentación hasta la integración.
curl -X POST https://api.runware.ai/v1 \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -d '[
    {
      "taskType": "imageInference",
      "model": "runware:400@1",
      "positivePrompt":
        "machinery, green-to-yellow gradient",
      "width": 1024,
      "height": 1024
    }
  ]'
● Sin servidores · Acceso anticipado
Trae tus contenedores y los pesos de tus modelos a la infraestructura modular de GPU detrás de la API de Runware. Ajusta la capacidad a la demanda en lugar de aprovisionarla para cada momento de baja actividad.
Trae tu contenedor y los pesos de tu modelo. Despliega sin gestionar la infraestructura subyacente.
$1.99/hour por RTX PRO 6000, frente a las tarifas habituales publicadas de $3.00–$4.00 en otros proveedores. La infraestructura modular está diseñada para reducir el costo de cómputo.
Explora el cómputo sin servidor conEmpieza con cómputo flexible. Una vez que tengas clara tu demanda base, considera la capacidad reservada o el hardware dedicado para cargas de trabajo con una demanda más estable.
Capacidad reservada
por GPU-hour en cómputo sin servidor
Servidores bare metal
configuraciones personalizadas en Sonic Pods
El hardware diseñado para este fin, un motor de inferencia dedicado y modelos conocidos pueden cambiar los costos de generación.
Las cifras mostradas son ilustrativas para este modelo y volumen seleccionados; las condiciones reales dependen del proveedor y de la carga de trabajo.
Diferencia mensual ilustrativa
$29.1Ken el ejemplo anteriorComparaciones de modelos seleccionados
Conecta tus herramientas e incorpora el acceso a modelos al flujo de trabajo que ya utilizas. Empieza con una clave API y un entorno de desarrollo conocido.
✓ conectado · OAuth 2.1
✓ tools · run · list_models · model_schema
>
Conecta un cliente MCP y trabaja desde una interfaz conocida.
Ejecuta modelos desde tu terminal.
Ofrece a los agentes de programación instrucciones para usar Runware.
«Excelentes precios y flexibilidad de la API. Nuestros usuarios quieren probar todos los modelos, hiperparámetros, LoRA y opciones. Otros proveedores los reparten entre distintos endpoints. Runware los unifica todos».
Inferencia cerca de los usuarios, sin tener que aprovisionar GPUs para cada idea nueva.
Preguntas que hacen los desarrolladores antes de la primera llamada. Explora la plataforma para conocer los detalles de tu carga de trabajo.
Usa una estructura de API uniforme para tareas compatibles de imagen, vídeo, audio, lenguaje y 3D, en lugar de integrar cada modalidad desde cero.
Combina software de orquestación e infraestructura modular diseñados específicamente para la inferencia.
El objetivo es ejecutar los mismos modelos en una infraestructura más eficiente, reduciendo la sobrecarga computacional en lugar de cambiar el modelo que elegiste.
El cómputo dedicado es una opción cuando una carga de trabajo necesita capacidad y una configuración de hardware propias.
Runware indica que las entradas y salidas de los clientes no se utilizan para entrenar modelos. Consulta las condiciones pertinentes sobre el tratamiento de datos para tu caso de uso.