Capacidade reservada
A partir de $0.99
por GPU-hour na computação sem servidor
- •Comprometa-se com um número de GPUs por um período determinado.
- •Aumente o uso além da reserva quando necessário.
Desenvolvendo com a Runware
Quatro camadas, desenvolvidas para trabalhar juntas. A orquestração e os Sonic Pods modulares formam o Sonic Inference Engine®.
Explore a plataforma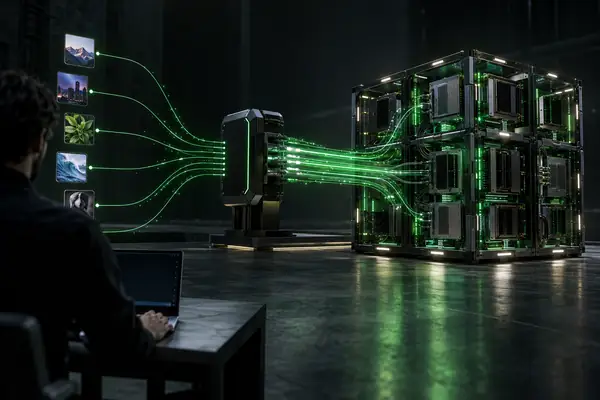
Solicitações de inferência processadas em imagem, vídeo, áudio, linguagem e 3D.
Modelos acessíveis por meio de uma abordagem unificada para cargas de trabalho de IA.
Desenvolvedores criando experiências com IA usando a Runware.
Pessoas alcançadas por aplicativos executados na infraestrutura.
Custos de geração menores do que os preços de mercado publicados para modelos selecionados.
Disponibilidade da plataforma registrada nos últimos 90 dias.
Modelos e modalidades em um só lugar, com um caminho consistente da experimentação à integração.
curl -X POST https://api.runware.ai/v1 \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -d '[
    {
      "taskType": "imageInference",
      "model": "runware:400@1",
      "positivePrompt":
        "machinery, green-to-yellow gradient",
      "width": 1024,
      "height": 1024
    }
  ]'
● Serverless · Acesso antecipado
Traga seus contêineres e pesos de modelos para a infraestrutura modular de GPU por trás da API da Runware. Dimensione o processamento conforme a demanda, em vez de provisionar recursos para cada momento de baixa atividade.
Traga seu contêiner e os pesos do seu modelo. Implante sem gerenciar a infraestrutura subjacente.
$1.99/hour para RTX PRO 6000, em comparação com os preços típicos publicados de $3.00–$4.00 em outros lugares. A infraestrutura modular foi projetada para reduzir o custo de computação.
Explore a computação de GPU sem servidor.Comece com computação flexível. Quando sua demanda de referência estiver clara, considere capacidade reservada ou hardware dedicado para cargas de trabalho com demanda mais estável.
Capacidade reservada
por GPU-hour na computação sem servidor
Bare metal
configurações personalizadas em Sonic Pods
Hardware desenvolvido para esse fim, um mecanismo de inferência dedicado e modelos conhecidos podem mudar a economia da geração.
Os valores ilustrativos apresentados correspondem ao modelo e ao volume selecionados; as condições reais dependem do provedor e da carga de trabalho.
Diferença mensal ilustrativa
$29.1Kno exemplo acimaComparações de modelos selecionados
Conecte suas ferramentas e integre o acesso aos modelos ao fluxo de trabalho que você já usa. Comece com uma chave de API e um ambiente de desenvolvimento familiar.
✓ conectado · OAuth 2.1
✓ ferramentas · run · list_models · model_schema
>
Conecte um cliente MCP e trabalhe em uma única interface familiar.
Acesse modelos pelo terminal.
Oriente agentes de programação no uso da Runware.
“Ótimos preços e uma API flexível. Nossos usuários querem experimentar todos os modelos, hiperparâmetros, LoRAs e opções. Outros provedores distribuem tudo isso por diferentes endpoints. A Runware reúne tudo em um só lugar.”
Inferência próxima dos usuários, sem precisar provisionar GPUs para cada nova ideia.
Perguntas que desenvolvedores fazem antes da primeira chamada. Explore a plataforma para saber mais sobre sua carga de trabalho.
Use uma estrutura de API consistente para tarefas de imagem, vídeo, áudio, linguagem e 3D compatíveis, em vez de integrar cada modalidade do zero.
Ele reúne software de orquestração e infraestrutura modular projetados especificamente para inferência.
O objetivo é executar os mesmos modelos em uma infraestrutura mais eficiente, reduzindo a sobrecarga computacional em vez de alterar o modelo que você escolheu.
A computação dedicada é uma opção quando uma carga de trabalho precisa de capacidade e configuração de hardware próprias.
A Runware afirma que as entradas e saídas dos clientes não são usadas para treinar modelos. Consulte os termos de tratamento de dados pertinentes ao seu caso de uso.